[BOT] Mon bot est il réalisable ?
Salut les kheys ,
je suis débutant en programmation mais j'aimerai coder un bot qui m'envoie une notif/message quand une annonce, ( qui correspond a certains critères) est poster sur un site .
Est ce que c'est réalisable ? si oui quel langage me conseillés vous ?
Merci

oui, le langage que tu veux
Tu peux regarder sur github t'auras peut être des sources concernant ton site
Oui parfaitement réalisable. Quelques lignes de code Python et c'est dans la poche 

si le site en question met a disposition une API, oui
dans le cas contraire ça va être tendu
Merci pour vos réponses les kheys , j'avoue que je suis 100% débutant donc si vous avez des bons sites pour apprendre à créer ce que je veux je suis preneur !
up
Le 28 octobre 2020 à 16:50:42 Ziguiiiz a écrit :
Merci pour vos réponses les kheys , j'avoue que je suis 100% débutant donc si vous avez des bons sites pour apprendre à créer ce que je veux je suis preneur !
c'est un site connu?
Le 28 octobre 2020 à 23:00:40 mov_eax_0 a écrit :
Le 28 octobre 2020 à 16:50:42 Ziguiiiz a écrit :
Merci pour vos réponses les kheys , j'avoue que je suis 100% débutant donc si vous avez des bons sites pour apprendre à créer ce que je veux je suis preneur !c'est un site connu?
Vinted
ils proposent pas d'api publique mais en cherchant un peu tu peux trouver celle qu'ils utilisent sur leur site ;)

Utilise php ou python pour checker régulièrement ton site. T'as besoin d'un serveur et du mot clé "cron" à chercher sur google pour exécuter ton script régulièrement.
Pour le message, peut-être que ton opérateur téléphonique te donne accès à une API pour t'envoyer des SMS à toi-même, je sais qu'on pouvait le faire facilement avec Free y'a quelques années. Sinon installe Telegram sur ton téléphone et utilise leur API pour créer un bot qui t'enverra des messages, ça fonctionne bien.
J'avais fait un script du genre qui vérifiait quelque chose sur jvc et envoyait un message sur un groupe Telegram, le code était celui-ci, je l'ai simplifié. Il te faudra quand même des bases pour le comprendre.
<?php

ini_set('max_execution_time', 0);
error_reporting(E_ALL);
ini_set('display_errors', 1);

function Request($url)
{
  $curl = curl_init();
  curl_setopt($curl, CURLOPT_URL, $url);
  curl_setopt($curl, CURLOPT_RETURNTRANSFER, 1);
  curl_setopt($curl, CURLOPT_FOLLOWLOCATION, 1);
  $data = curl_exec($curl);
  curl_close($curl);
  return $data;
}

// Get js from jvc

$data = Request("http://www.jeuxvideo.com/forums/0-1000021-0-1-0-1-0-communaute.htm");
preg_match('`<meta charset="utf-8">\n<script src="data:text/javascript;base64,(.+)"></script>\n<meta name="viewport"`isU', $data, $out);
$js = base64_decode($out[1]);

if (trim($js) == "")
  die("Empty");

// Telegram alert

$msg = "Mise à jour du script anti-jvp";
$url  = "https://api.telegram.org/bot66209743:AAEy1DSpVdLIF0s6yYZwKhyzhhlPPxRfs/sendMessage?chat_id=-2710995&text=$msg";
file_get_contents($url);
Va falloir commencer par la base, cherche un tuto de débutant en php. Ou python, tu peux faire l'équivalent.
Le 30 octobre 2020 à 23:57:10 Chocolayte a écrit :
Utilise php ou python pour checker régulièrement ton site. T'as besoin d'un serveur et du mot clé "cron" à chercher sur google pour exécuter ton script régulièrement.Pour le message, peut-être que ton opérateur téléphonique te donne accès à une API pour t'envoyer des SMS à toi-même, je sais qu'on pouvait le faire facilement avec Free y'a quelques années. Sinon installe Telegram sur ton téléphone et utilise leur API pour créer un bot qui t'enverra des messages, ça fonctionne bien.
J'avais fait un script du genre qui vérifiait quelque chose sur jvc et envoyait un message sur un groupe Telegram, le code était celui-ci, je l'ai simplifié. Il te faudra quand même des bases pour le comprendre.
<?php

ini_set('max_execution_time', 0);
error_reporting(E_ALL);
ini_set('display_errors', 1);

function Request($url)
{
  $curl = curl_init();
  curl_setopt($curl, CURLOPT_URL, $url);
  curl_setopt($curl, CURLOPT_RETURNTRANSFER, 1);
  curl_setopt($curl, CURLOPT_FOLLOWLOCATION, 1);
  $data = curl_exec($curl);
  curl_close($curl);
  return $data;
}

// Get js from jvc

$data = Request("http://www.jeuxvideo.com/forums/0-1000021-0-1-0-1-0-communaute.htm");
preg_match('`<meta charset="utf-8">\n<script src="data:text/javascript;base64,(.+)"></script>\n<meta name="viewport"`isU', $data, $out);
$js = base64_decode($out[1]);

if (trim($js) == "")
  die("Empty");

// Telegram alert

$msg = "Mise à jour du script anti-jvp";
$url  = "https://api.telegram.org/bot66209743:AAEy1DSpVdLIF0s6yYZwKhyzhhlPPxRfs/sendMessage?chat_id=-2710995&text=$msg";
file_get_contents($url);
Va falloir commencer par la base, cherche un tuto de débutant en php. Ou python, tu peux faire l'équivalent.
Merci mon khey ca m'aide énormément ! Donc selon toi c'est faisable en 100% php?
Yep tout à fait. Note toutefois que c'est aussi faisable à 100% en python, à 100% en node js, à 100% en bash et pas mal d'autres langages... Ton programme se constitue de quatre étapes pas bien complexes, 1) faire une requête sur ton site 2) analyser le contenu de la page 3) envoyer une notification sms / telegram / autre si ta condition est remplie 4) paramétrer ton cron pour que ton fichier s'exécute toutes les X minutes / heures / jours.
Et peut-être une dernière étape un soupçon plus complexe que le reste qui consiste en un système qui empêchera ton programme d'envoyer plusieurs fois la même notification pour un même contenu.
Mais n'importe quel langage qui fonctionne côté serveur peut faire l'affaire. Tu devrais t'en sortir en PHP, il y a beaucoup de documentation, d'exemples, l'apprentissage est plutôt aisé.
Yo les kheys je revient vers vous après avoir un peu avancer , je fais du web scraping avec python et beautiful soup voici mon code pour l'instant :
from urllib.request import urlopen as uReq
from bs4 import BeautifulSoup as soup
my_url = 'https://www.vinted.fr/vetements?size_id[]=207&catalog[]=79&brand_id[]=304&price_to=20&status[]=1&status[]=6&status[]=2'
uClient = uReq(my_url)
page_html = uClient.read()
uClient.close()
page_soup = soup(page_html, "html.parser")
Ensuite quand j'écris "page_soup.h1" rien ne ce passe .
Quand jessaye de donner une variable html findall, et que je fais "len("nom de ma variable") la console me répond 0 j'avoue que je suis perdu
up
Malheureusement, le contenu est généré avec Javascript donc impossible de scraper du HTML avec BeautifulSoup et requests. Faut passer par selenium. Voici un code qui t'affiche les articles de la première page pour t'aider :
# https://www.jeuxvideo.com/forums/42-47-64620468-1-0-1-0-bot-mon-bot-est-il-realisable.htm
# vinted.py

from selenium import webdriver
from prettytable import PrettyTable

my_url = 'https://www.vinted.fr/vetements?size_id[]=207&catalog[]=79&brand_id[]=304&price_to=20&status[]=1&status[]=6&status[]=2'

driver = webdriver.Firefox()
content = driver.get(my_url)

x = PrettyTable()
x.field_names = ["Username", "Price", "Size", "Brand"]

article_body = driver.find_element_by_class_name('feed-grid')
articles = article_body.find_elements_by_class_name("feed-grid__item")

for article in articles:
    try:

        user, price, size, brand = [elem.text for elem in article.find_elements_by_class_name('Text_text__QBn4-')]
        user = user.strip()
        price = price.strip()
        size = size.strip()
        brand = brand.strip()

        x.add_row([user, price, size, brand])

    except ValueError:
        pass

print(x)
Ça affiche un truc comme ça :
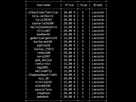
Avec l'URL en prime 
# https://www.jeuxvideo.com/forums/42-47-64620468-1-0-1-0-bot-mon-bot-est-il-realisable.htm
# vinted.py

from selenium import webdriver
from prettytable import PrettyTable

my_url = 'https://www.vinted.fr/vetements?size_id[]=207&catalog[]=79&brand_id[]=304&price_to=20&status[]=1&status[]=6&status[]=2'

driver = webdriver.Firefox()
content = driver.get(my_url)

x = PrettyTable()
x.field_names = ["Username", "Price", "Size", "Brand", "URL"]

article_body = driver.find_element_by_class_name('feed-grid')
articles = article_body.find_elements_by_class_name("feed-grid__item")

for article in articles:
    try:

        user, price, size, brand = [elem.text for elem in article.find_elements_by_class_name('Text_text__QBn4-')]
        link = article.find_element_by_class_name('c-box__overlay').get_attribute('href')

        user = user.strip()
        price = price.strip()
        size = size.strip()
        brand = brand.strip()
        link = link.strip()

        x.add_row([user, price, size, brand, link])

    except ValueError:
        pass

print(x) 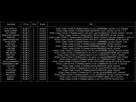
Erratum, je viens de me rendre compte que la variable content de mon code ne servait à rien (je l'utilisais pour inspecter le HTML mais j'ai ensuite modifié le programme).
Tu peux juste faire :
driver.get(my_url)Au lieu de :
content = driver.get(my_url) # Là, on stocke une référence vers l'objet driver qu'on utilise jamais par la suiteEt ensuite tu manipules ton objet driver pour scraper les éléments.
Incroyable merci khey ! C'est fantastique à quel point vous êtes competent et serviable sur ce forum!
Bon voici une MàJ du programme, je vais détailler un peu ce que j'ai fait. Je suis reparti de mon script précédent mais le but c'est d'avoir un truc qui fonctionne en arrière plan donc on vire prettytable et on exécute selenium en mode headless (sans interface).
    options = Options()
    options.headless = True
    driver = webdriver.Firefox(options=options)
    driver.get(url)

    article_body = driver.find_element_by_class_name('feed-grid')
    articles = article_body.find_elements_by_class_name("feed-grid__item")
Ensuite, je créé une liste qui me servira à recevoir tous mes items et qui seront représentés via des dictionnaires (facile à écrire dans un fichier csv avec dictWriter. Au passage, j'en profite pour ajouter le nom du fichier, le timestamp et surtout l'ID qui nous servira de "clé primaire" au moment de récupérer tous les IDs de tous les items pour savoir si on a déjà stocké le fichier dans le csv. L'ID est facile à récupérer car il est présent dans l'url.
    list_of_items = []

    for article in articles:
        try:

            user, price, size, brand = [elem.text for elem in article.find_elements_by_class_name('Text_text__QBn4-')]
            link = article.find_element_by_class_name('c-box__overlay').get_attribute('href')

            item = dict()

            user = user.strip()
            price = price.strip()
            size = size.strip()
            brand = brand.strip()
            link = link.strip()
            name = " ".join(link.split("/")[-1].split("-")[1:]).title()
            id_ = link.split('/')[-1].split('-')[0]

            item['user'] = user
            item['price'] = price
            item['size'] = size
            item['name'] = name
            item['brand'] = brand
            item['link'] = link
            item['id'] = id_
            item['datetime'] = datetime.now().isoformat()

            list_of_items.append(item)
Ensuite, on écrit quelques fonctions (je ne mets pas l'intégralité du code de chaque fonction pour que ça reste lisible). Une fonction qui va récupérer tous les ids du fichier csv (on renvoie un set car plus rapide qu'on liste pour tester si un élément est présent ou non) :
def create_csv_file(filename: str, fieldnames: List[str]) -> None:
    ids = set()
    with open(filename, mode="r") as csvfile:
        reader = csv.DictReader(csvfile)
        for row in reader:
            ids.add(row['id'])
    return ids
Une autre fonction qui écrit l'item dans le fichier (pas très efficace car ça implique d'ouvrir, écrire, fermer le fichier pour chaque item mais on aura peu d'I/O dans notre programme donc on peut se le permettre et le programme sera plus lisible) :
def add_item_to_file(item: Dict, filename: str, fieldnames: List[Dict]) -> None:

    with open(filename, mode="a", encoding="utf-8") as csvfile:
        writer = csv.DictWriter(csvfile, fieldnames=fieldnames)
        writer.writerow(item)
À ce stade on a toutes nos fonctions, on n'a plus qu'à assembler tout ça dans une fonction main et de l'appeler par la suite :
def main():
    FILENAME = "vinted.csv"
    FIELDNAMES = ['id', 'user', 'price', 'size', 'name', 'brand', 'link', 'datetime']
    URL = "https://www.vinted.fr/vetements?size_id[]=207&catalog[]=79&brand_id[]=304&price_to=20&status[]=1&status[]=6&status[]=2&order=newest_first"

    # Création du fichier dans lequel on stockera nos articles
    if not os.path.exists(FILENAME):
        create_csv_file(FILENAME, FIELDNAMES)
        logger.info(f"Creating the file `{FILENAME}`.")

    # Récupération de tous les ID
    set_of_ids = get_all_ids(FILENAME)
    logger.info(f"Recovery of all the IDs of the `{FILENAME}` file.")

    new_items = []
    for item in get_all_items(URL):

        if item['id'] not in set_of_ids:  # Si l'ID de l'article n'est pas dans le fichier, on ne l'a pas encore scrapé.
            add_item_to_file(item, FILENAME, FIELDNAMES)
            logger.info(f"New item, added to the file `{FILENAME}` : `{item}`.")
            new_items.append(item)

        else:
            logger.info(f"Item already saved in the file `{FILENAME}` : `{item}`.")

    if new_items:  # S'il y a des nouveaux items, on envoie une notification.
        logger.info("New items saved, preparation of the telegram notification.")

        # Ici, on place la fonction qui envoie une notification via telegram.
        # send_telegram_notification(new_items, user, password, channel)

    # On vide la liste des nouveaux items
    new_items.clear()
Forcément, on ne fait plus de print étant donné que le programme tournera en arrière plan. On utilise logger configuré au début :
logging.basicConfig(format="%(asctime)s %(levelname)-8s [%(filename)s:%(lineno)d] %(message)s",
                    datefmt="%Y-%m-%d %H:%M:%S",
                    level=logging.INFO,
                    filename="vinted.log")

logger = logging.getLogger("vinted_scraper")
Ensuite, on doit exécuter le script tous les jours pour scraper les derniers articles. Le module sched de Python est assez complexe à utiliser donc j'utilise schedule de Dan Brader (le fondateur du site RealPython). Le module s'utilise relativement facilement, il suffit d'appeler la fonction qu'on souhaite exécuter et de fixer la périodicité :
if __name__ == "__main__":

    # On exécute le script directement (test et debugging)
    # main()

    # On exécute le script tous les jours à 18H00.
    schedule.every().day.at("18:00").do(main)

    # On exécute le script toutes les heures.
    # schedule.every(60).minutes.do(main)

    while True:
        schedule.run_pending()
        time.sleep(1)
Voilà, c'est terminé, tu n'as plus qu'à intégrer ta notification telegram dans la fonction main. Ensuite il faudra lancer le programme en arrière plan et le détacher du terminal. Sur Linux, on fait comme ça, sous windows je sais pas trop mais bon j'imagine que c'est faisable facilement.
nohup python3 vinted.py &Le code complet :
# https://www.jeuxvideo.com/forums/42-47-64620468-1-0-1-0-bot-mon-bot-est-il-realisable.htm
# vinted.py

import csv
import logging
import os
import time
from datetime import datetime
from typing import Dict, List, Set

import schedule
from selenium import webdriver
from selenium.webdriver.firefox.options import Options

logging.basicConfig(format="%(asctime)s %(levelname)-8s [%(filename)s:%(lineno)d] %(message)s",
                    datefmt="%Y-%m-%d %H:%M:%S",
                    level=logging.INFO,
                    filename="vinted.log")

logger = logging.getLogger("vinted_scraper")


def get_all_items(url: str) -> List[Dict]:
    """Function that returns a dictionary list of all items on the url page.

    Args:
        url (str): URL of the page to scrap.

    Returns:
        List: return a list of all items
    """

    options = Options()
    options.headless = True
    driver = webdriver.Firefox(options=options)
    driver.get(url)

    article_body = driver.find_element_by_class_name('feed-grid')
    articles = article_body.find_elements_by_class_name("feed-grid__item")

    list_of_items = []

    for article in articles:
        try:

            user, price, size, brand = [elem.text for elem in article.find_elements_by_class_name('Text_text__QBn4-')]
            link = article.find_element_by_class_name('c-box__overlay').get_attribute('href')

            item = dict()

            user = user.strip()
            price = price.strip()
            size = size.strip()
            brand = brand.strip()
            link = link.strip()
            name = " ".join(link.split("/")[-1].split("-")[1:]).title()
            id_ = link.split('/')[-1].split('-')[0]

            item['user'] = user
            item['price'] = price
            item['size'] = size
            item['name'] = name
            item['brand'] = brand
            item['link'] = link
            item['id'] = id_
            item['datetime'] = datetime.now().isoformat()

            list_of_items.append(item)

        except ValueError:
            pass

    driver.quit()

    return list_of_items


def get_all_ids(filename: str) -> Set:
    """Function that returns the set of all ids of all items saved in the file.

    Args:
        filename (str): File where items are saved.

    Returns:
        Set: Set of ids.
    """

    ids = set()
    with open(filename, mode="r") as csvfile:
        reader = csv.DictReader(csvfile)
        for row in reader:
            ids.add(row['id'])
    return ids


def create_csv_file(filename: str, fieldnames: List[str]) -> None:
    """Function that creates the backup file.

    Args:
        filename (str): File where items are saved.
        fieldnames (List): List containing item headers.
    """

    with open(filename, mode="w", encoding="utf-8") as csvfile:
        writer = csv.writer(csvfile)
        writer.writerow(fieldnames)


def add_item_to_file(item: Dict, filename: str, fieldnames: List[Dict]) -> None:
    """Function that adds an item to the file.

    Args:
        item (Dict): Dictionary representing an item.
        filename (str): File where items are saved.
        fieldnames (List): List containing item headers.
    """

    with open(filename, mode="a", encoding="utf-8") as csvfile:
        writer = csv.DictWriter(csvfile, fieldnames=fieldnames)
        writer.writerow(item)


def main():
    FILENAME = "vinted.csv"
    FIELDNAMES = ['id', 'user', 'price', 'size', 'name', 'brand', 'link', 'datetime']
    URL = "https://www.vinted.fr/vetements?size_id[]=207&catalog[]=79&brand_id[]=304&price_to=20&status[]=1&status[]=6&status[]=2&order=newest_first"

    # Création du fichier dans lequel on stockera nos articles
    if not os.path.exists(FILENAME):
        create_csv_file(FILENAME, FIELDNAMES)
        logger.info(f"Creating the file `{FILENAME}`.")

    # Récupération de tous les ID
    set_of_ids = get_all_ids(FILENAME)
    logger.info(f"Recovery of all the IDs of the `{FILENAME}` file.")

    new_items = []
    for item in get_all_items(URL):

        if item['id'] not in set_of_ids:  # Si l'ID de l'article n'est pas dans le fichier, on ne l'a pas encore scrapé.
            add_item_to_file(item, FILENAME, FIELDNAMES)
            logger.info(f"New item, added to the file `{FILENAME}` : `{item}`.")
            new_items.append(item)

        else:
            logger.info(f"Item already saved in the file `{FILENAME}` : `{item}`.")

    if new_items:  # S'il y a des nouveaux items, on envoie une notification.
        logger.info("New items saved, preparation of the telegram notification.")

        # Ici, on place la fonction qui envoie une notification via telegram.
        # send_telegram_notification(new_items, user, password, channel)

    # On vide la liste des nouveaux items
    new_items.clear()

if __name__ == "__main__":

    # On exécute le script directement (test et debugging)
    # main()

    # On exécute le script tous les jours à 18H00.
    schedule.every().day.at("18:00").do(main)

    # On exécute le script toutes les heures.
    # schedule.every(60).minutes.do(main)

    while True:
        schedule.run_pending()
        time.sleep(1)
Voici une capture des logs, j'ai lancé le programme à 12h04 (premier scraping) puis je l'ai relancé manuellement à 12h25 et il a trouvé 3 nouveaux articles de silvamika (ajoutés 11 minutes avant).
Je pense pas que ça soit une bonne idée de partir sur Selenium. Ça serait beaucoup beaucoup plus simple de venir inspecter les requêtes qui sont faites et venir se brancher sur leur API.
- Aide à l'achat Mac
- Création de Jeux
- Linux
- Programmation
- Création de sites web
- Internet
- Steam Deck
- Macintosh
- Hardware